

Inizia la riscossa dei content creator, dei grafici e dei fotografi. E, ovviamente, anche dei copywriter. Da un lato abbiamo piattaforme come la stessa Substack e LinkedIn che danno degli strumenti per bacchettare i contenuti creati con l’AI. Dall’altro entrano in gioco le filigrane invisibili sia nelle immagini che nei testi per identificare i lavori che nascono dalla mano potente dell’intelligenza artificiale.
Questa condizione spaventa un po’ tutti perché per mesi siamo stati alimentati da promesse infinite rispetto alla possibilità di risolvere tutto con un prompt. Scrivere articoli con ChatGPT, creare immagini senza coinvolgere attori e creativi con nano Banana, moltiplicare schede prodotto senza sapere niente di ciò che si vende: una storia fantastica che oggi sembra incrociare una minaccia reale (o forse no).
Uno sguardo sul funzionamento delle filigrane
Il problema è questo: tu immagini le filigrane come una strisciolina multicolore visibile in controluce sulla carta moneta. Nei testi generati dall’AI, questo elemento non rientra nella categoria dei timbri visibili: le filigrane sono modelli matematici inseriti nel processo di generazione delle parole. Si tratta di un watermarking probabilistico o statistico che include la scelta di determinate parole in combinazione con le altre.
In sintesi, il testo generato dall’AI non ha una filigrana visibile. Ma si riconosce se si studiano bene le parole scelte per creare il testo. Per spiegare questo approccio prendo spunto dalle indicazioni lasciate sul sito declaude.org/watermarking.
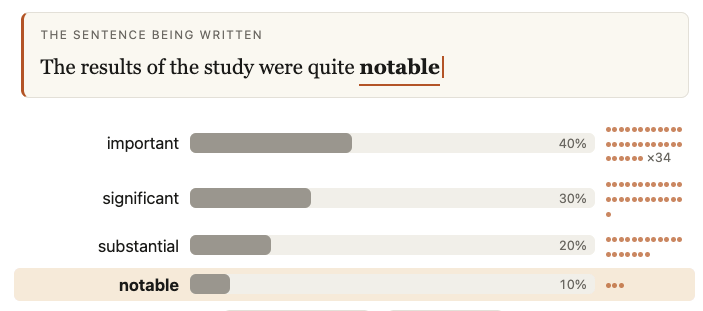
Un modello linguistico sceglie una parola alla volta considerando delle probabilità matematiche. L’algoritmo di filigrana del singolo LLM divide il vocabolario in due gruppi: una lista verde con tutte le parole incentivate e una rossa con dei termini scoraggiati. L’AI favorisce il primo gruppo e sceglie ciò che si trova nella lista verde, al posto dei termini presenti nel gruppo sfavorito.
Il lettore non percepisce nulla. Ma un tool pensato per riconoscere i testi creati con l’AI riconosce la filigrana1 - come quella di Google SynthID e di Claude - per poi comunicare all’utente che si trova davanti a un contenuto generato con l’AI.
Qualche dettaglio per approfondire
La filigrana generativa modifica la procedura di campionamento del token successivo per aggiungere leggere modifiche del contesto nella distribuzione del testo generato. Questi interventi introducono una firma statistica nel testo generato.
Durante la fase di rilevamento, la firma può determinare se il testo è stato effettivamente generato dall’LLM. La filigrana, per funzionare, deve avere due condizioni2: abbastanza dati (lunghezza) e sufficiente libertà di scelta (entropia). Quando l’AI scrive un testo creativo, una storia o una risposta aperta, per ogni parola ha a disposizione decine di sinonimi e alternative ugualmente valide. L’algoritmo di watermarking ha ampio margine di manovra per scegliere la parola che permette di creare la filigrana senza rovinare il senso della frase.
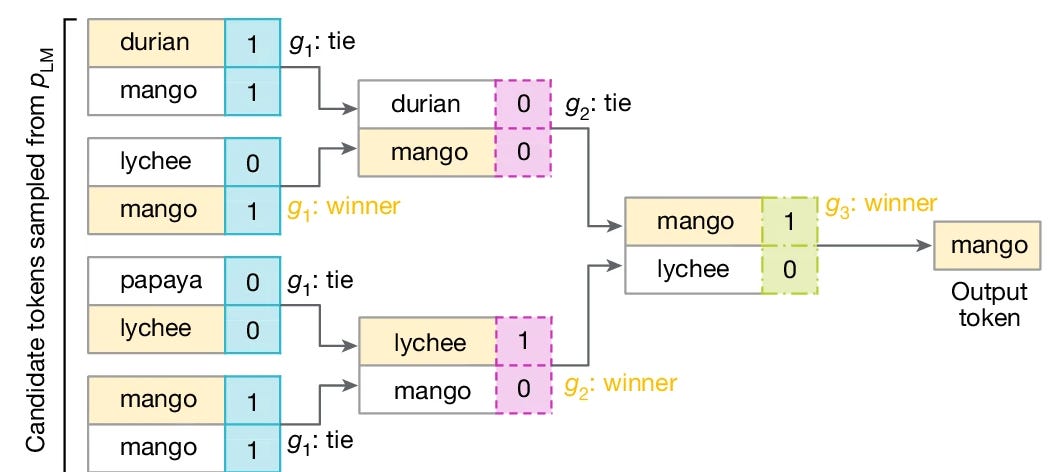
In queste circostanze, la filigrana funziona alla grande. Se l’intelligenza artificiale lavora su contenuti vincolati - come codice di programmazione, formule matematiche, citazioni storiche o elenchi di dati - spesso si possono scegliere poche alternative. A volte solo una. Risultato: L’AI non ha alternative.
L’algoritmo di filigrana non può forzare l’uso di parole diverse, altrimenti genererebbe un errore o una frase senza senso. La filigrana non può essere inserita e il meccanismo non opera in modo efficace.
Ora, c’è la filigrana: sono un truffatore?
Cioè, sei uno di quelli che viene pagato profumatamente e fa fare il lavoro a Claude o a Gemini? No, questa è la grande truffa che vogliono far passare: un testo che viene identificato come scritto o elaborato dall’AI non è stato scritto per forza solo con un processo di copia e incolla da un LLM.
Al tempo stesso, un contenuto che non riporta questa etichetta potrebbe essere nato ed elaborato da un tool come ChatGPT o Gemini. Questo perché - come ci ricorda proprio il comunicato stampa di Claude - la presenza della filigrana indica che il testo è stato elaborato e non scritto da un modello di intelligenza artificiale più o meno aggiornato. Ecco un estratto:
“Un contrassegno rilevato fornisce un segnale che il contenuto è stato elaborato da Claude, ma non è completamente conclusivo. Il rilevamento di un contrassegno Claude ti dice che il contenuto potrebbe essere stato elaborato da Claude. Non conferma, di per sé, la provenienza completa del contenuto”.
La documentazione di Anthropic conferma il punto: testi umani revisionati o tradotti da Claude riportano la filigrana. Un testo può essere scritto parzialmente dall’intelligenza artificiale, posso creare un paragrafo con l’AI, integrarlo in un documento scritto personalmente e modificare solo alcune frasi.
Se il blocco generato è abbastanza lungo (sì ma quanto?), la filigrana rimane visibile nel documento generando un falso positivo, tra l’altro ingiusto nei confronti dell’autore.
E l’assenza del marchio è ancora meno significativa: modelli datati possono generare testi non riconosciuti. Ma anche modifiche importanti possono generare risultati esenti da filigrana. Ciò avviene anche su testi creati dall’IA. Quindi, cosa possiamo dire in definitiva?
La presenza di una filigrana indica in modo statisticamente valido che il testo è stato elaborato o generato da un tool di intelligenza artificiale. Ma non dimostra in modo chiaro e confermato che sia proprio Gemini o Claude l’autore originale o esclusivo di un contenuto.
Si può eliminare la filigrana dai testi?
Sì, basta che scrivi il contenuto di tua mano. Ma a prescindere da questa ovvietà, molti si chiederanno come eludere i controlli e se esiste un metodo per non far apparire un testo con la filigrana della vergogna. Il concetto è semplice: per rimuovere una filigrana statistica (come SynthID o il watermarking di Claude) devi spezzare lo schema probabilistico dell’algoritmo di rilevamento.
Se la struttura di rilevamento viene profondamente alterata, la chiave di decodifica non riesce più a ricostruire le associazioni della famosa lista verde. Quindi tutto appare in regola. Per risolvere questo punto hai diverse opzioni:
Abbassare la lunghezza del testo. Se chiedi all’AI di generare stringhe di contenuto viene meno il vincolo della lunghezza. Quindi, un testo molto breve non offre la base necessaria alla fligrana per esprimersi.
Ridurre l’entropia. Cerca di vincolare il più possibile, attraverso un prompt, a determinate regole. Questo funziona bene, ovviamente, con tabelle e stili di scrittura molto specifici come quello giuridico.
Elimina dati con la traduzione. C’è questa condizione: se traduci il testo generato dall’AI in un’altra lingua e poi fai una nuova traduzione in italiano elimini la filigrana. Funziona? Non lo so, preferisco fare diversamente.
Profonda riscrittura. Secondo me questo è il punto essenziale, e anche quello eticamente più corretto. Aiutati con l’AI a organizzare le idee e poi esprimile modificando radicalmente la struttura delle frasi, la sintassi e il lessico. Ma aggiungi anche contenuti unici, esperienze personali, dati di prima mano e tutto ciò che ti consente di avere quell’information gain per vincere la sfida con i competitor. I cambi di parole spesso non bastano: serve una riorganizzazione profonda del testo per annulare l’impronta statistica.
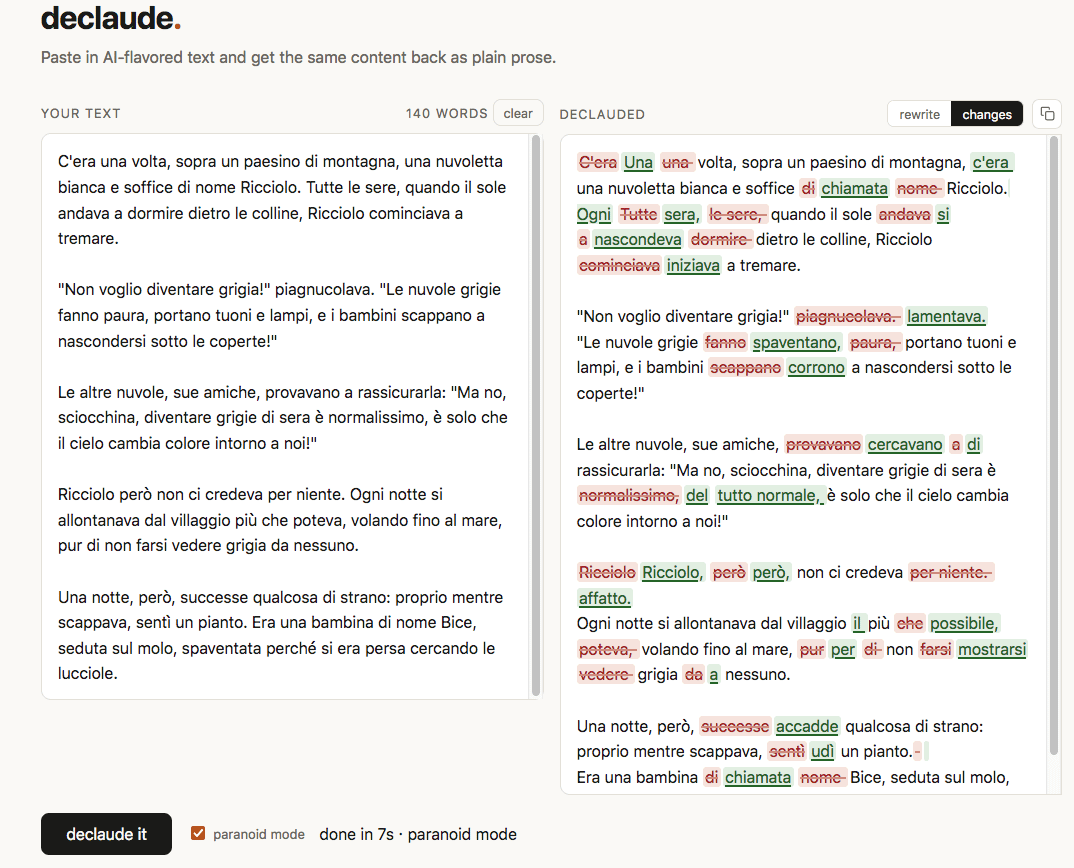
Per velocizzare il processo di elusione dello schema, e per capire come funziona, puoi utilizzare strumenti come Declaude che fa proprio questo: riscrive il testo in modo da spezzare la filigrana. Molto interessante anche la presenza di un’opzione paranoia per modifiche profonde ma la soluzione ideale resta l’apporto umano.
Molti suggeriscono anche di fare un copia e incolla senza formattazione, passando prima da Notepad e poi all’HTML. Questo serve solo a eliminare eventuali caratteri di formattazione: la sintassi Markdown (come asterischi ** per il grassetto o cancelletti # per i titoli), elementi CSS o spazi vuoti standard per rendere il testo più leggibile. È normale formattazione web e non parliamo di marcatori segreti da eliminare.
Qui il copywriter fa la differenza
Ci avevano dati per spacciati, vero? in realtà non è così. La riscrittura superficiale e i cambi di parole isolati non bastano quando decidi di crear eun testo con l’AI. Per rompere lo schema statistico devi andare oltre: serve una riorganizzazione sintattica profonda. Chi la fa? Chi se ne occupa? Chi cura l’aggiunta di quell’Information Gain fatto di esperienze dirette, opinioni, dati di prima mano ed estro che nessun algoritmo potrà mai curare?
I normali AI Detector online (come GPTZero o simili) non vedono le filigrane di SynthID o Claude. Per leggere una filigrana probabilistica serve la chiave segreta che è in mano ai provider.
La cosa assurda è che sarà sempre un modello generativo che valuterà se il tuo testo è stato scritto da un AI! Alla fine, si sta cercando di ovviare il problema, ma l’intelligenza artificiale, fra qualche anno o mese, ci sarà anche per farci il caffè la mattina! In quel caso cosa faremo? Dovremo avere un altro modello che ci dice se il caffè è fatto da una macchina?